ANALYSIS OF METHODS FOR EXTRACTING INFORMATION FROM TEXTS IN NATURAL LANGUAGE
Abstract
The article describes approaches to the formulation of a universal method for analyzing text messages that have a complex structure in the existing text.
Keywords
text analysis, formalization apparatus, text processing, information extraction
I. M. Boynazarov – TATU Samarqand filiali dotsenti,
F. Shokirov – SamDU Xalqaro ta’lim dasturlari fakulteti magistri,
U. Beknazarova – TATU Samarqand filiali magistri.
Ushbu ishda mavjud matndagi murakkab strukturaga ega bo‘lgan matnli xabarlarni tahlil qilish uchun universal usulni shakllantirishga bo‘lgan yondoshuvlar bayon qilingan.
Kalit so‘zlar: matn tahlili, formallashtirish apparati, matni qayta ishlash, axborotni ajratib olish.
Hozirgi kunda matnlarni qayta ishlashning eng ilg‘or yo‘nalishlaridan biri bu tabiiy tildagi matndan zarur ma’lumotlarni ajratib olish hisoblanadi. Matndan ma’lumot ajratish bu intelektual jarayon bo‘lib, bunda hozirda mavjud axborotlarni ajratib olish usullari yetarli emas. Bu muammo, sun’iy ong apparati va ma’lumotlarni qayta ishlashning evristik usullarining qo‘llanishi bilan hal qilinadi. Axborotni ajratib olishdan asosiy maqsad - dastlab ma’lumotlarni qayta ishlashning standart usullari orqali tasvirlangan matndagi xaotik axborotni tahlil qilish hisoblanadi. Matnli axborotni qayta ishlash masalasida matnni generatsiya qilish muammosi alohida o‘rin tutadi.
Matnli axborotni qayta ishlashga oid ko‘pgina masalalar mavjudligini hisobga olgan holda axborotni tahlil qilish bilan bog‘liq bo‘lgan sinflarni keltiramiz:
- o‘z nomiga ega elementlarni tanib olish (masalan, odamning ismi, tashkilot nomi va h.k.);
- aynan bitta obyekt bilan bog‘liq ma’lumotlarni izlash;
- atamalarnini ajratish, kalit so‘zlarni belgilash;
- avtoreferatlashtirish: ma’noli qismini ajratish;
- til korpusi: alohida matn uchun korpus ajratib olish va undan foydalanish;
- elektron lug‘atlar, tezauruslar, ko‘rsatkichlar yaratish;
- matnlar tarjimasini avtomatlashtirish;
- matndan aniq dalillarni ajratib olishni avtomatlashtirish;
- bilimlarni boshqaruvchi tizimlarni ishlab chiqish;
- savol-javob tizimini yaratish;
- axborotli qidiruvni avtomatlashtirish.
Sanab o‘tilgan masalalarni yechish uchun quyidagi usullardan foydalaniladi:
- Data mining
- Asotsiativ qoidalar
- Produktiv model
- Mantiqiy-formal model
- Freymli model
- Semantik-tarmoqli model
- Yechimlar daraxti
- Klasterlar
- Matematik funksiyalar va boshqalar.
Bu usullar tahlili shuni ko‘rsatadiki, ularning har biri ma’lum bir masalani to‘liqligicha ochib beradi, ammo ularning barchasida muhim kamchiliklar mavjud. Bular matnni mantiqsiz va to‘liq ekanligini tasvirlashga yo‘l qo‘ymaydi. Natijada, matndagi mantiqiy va mantiqsiz ma’noga ega ma’lumotlar ziddiyati kelib chiqadi. Shunday qilib, yuqoridagi usullardan olingan natijalar shu usullarning imkoniyatlari bilan chegaralangan.
Keltirilgan kamchiliklarni ham bartaraf etish uchun ma’lumotlar tahlili algoritmi va protseduralariga asoslangan ulkan ma’lumotlar va bilimlar bazasi kerak bo‘ladi. Bu algoritm va protseduralar quyidagi struktura orqali amalga oshirilishi mumkin. (1-rasm)
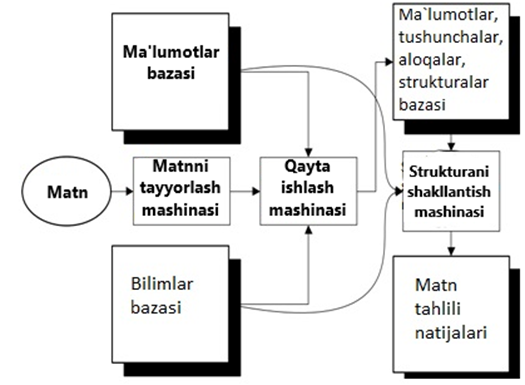
1-rasm. Ma’lumotlarni qayta ishlash strukturasi
Rasmda tasvirlangan ma’lumotlarni qayta ishlash strukturasi orqali bilimlar bazasi va ma’lumotlar bazasi bloklari strukturasini batafsil tasvirlash mumkin. Bunday qismlarga ajratish masalaning kelib chiqishini tavsiflab beradi. Yuqorida keltirilgan masalalarni hisobga olgan holda ushbu ma’lumotlarni qayta ishlash tizimi uchun gibrid ma’lumotlar bazasiga ehtiyoj borligi seziladi. Bu turdagi bazalar bir nechta usullarni birlashtiruvchi gibrid tizimga aylanadi. Bunday gibrid bazalar bilan ham ko‘plab muammolarga duch kelish mumkin. Masalan, ma’lumotlarni mantiqiy bog‘langan holda chop qilishni tashkil etish.
Umuman olganda, bunday masalalarni noravshan to‘plamlar haqidagi teoremaga tayangan holda hal qilish mumkin. Matnni qayta ishlashning birinchi bosqichi, tabiiy tilda yozilgan matnni formal modelga o‘girish bilan boshlanadi. Bu model haqiqiy matnning aksini ifodalaydi. Bu holda esa matnni qayta ishlash strukturasi qutidagicha bo‘ladi. (2-rasm)
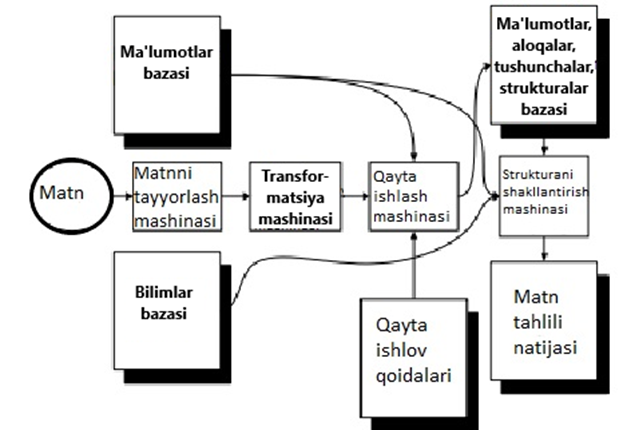
2-rasm. Matnlarni qayta ishlashning to‘ldirilgan strukturasi
Ushbu to‘ldirilgan strukturada matn o‘girish transformatsiya qilish mashinasi blokida sodir bo‘ladi. Bunda formal model ustida oddiy qo‘shish, ayirish, ko‘pytirish va bo‘lish amallarini bajarish mumkin. Bu turdagi strukturaga misol sifatida matnning strukturali birliklari vektori ko‘rinishini, ya’ni harflar, so‘zlar, iboralar, gaplarni keltirish mumkin.
Matnlarni qayta ishlashning 2-rasmda keltirilgan to‘ldirilgan strukturasi ham gibrid bazadagi ma’lumotlar hajmining ortib ketishiga sabab bo‘ladi. Xulosa qilib aytish mumkinki, sanab o‘tilgan barcha usullardan eng muqobili bu matnni semantik va sintaktik tahlil qilish o‘rniga uni formal modelga o‘tkazish sharti bilan algebraik almashtirishlarni qo‘llash orqali qayta ishlashdir.
Adabiyotlar:
1. Sunita Sarawagi. Information Extraction – Foundations and Trends in Databases // Vol. 1, 2007. No. 3. – p. 261 – 377.
2. Hamish Cunningham. Automatic Information Extraction, 2004. – р. 22.
3. Fabian M. Suchanek. Information Extraction, 2011, [Электрон ресурс] – suchanek.name/work/ teaching/IE2011a.pdf.
4. Бутов, А.Л., Миргалеев, А.Т. Метод извлечения фактов в информационно-аналитических системах из информации, представленной на естественном языке. //Информационно-измерительные и управляющие системы. – М.: Радиотехника. №2, 2012.
Comments